Szwagierka poprosiła mnie o rozwiązanie, które kiedyś pokazałem jej na TikToku. Jednak zamiast korzystać z gotowego serwisu do zbierania zdjęć od gości postanowiłem zbudować własne narzędzie.
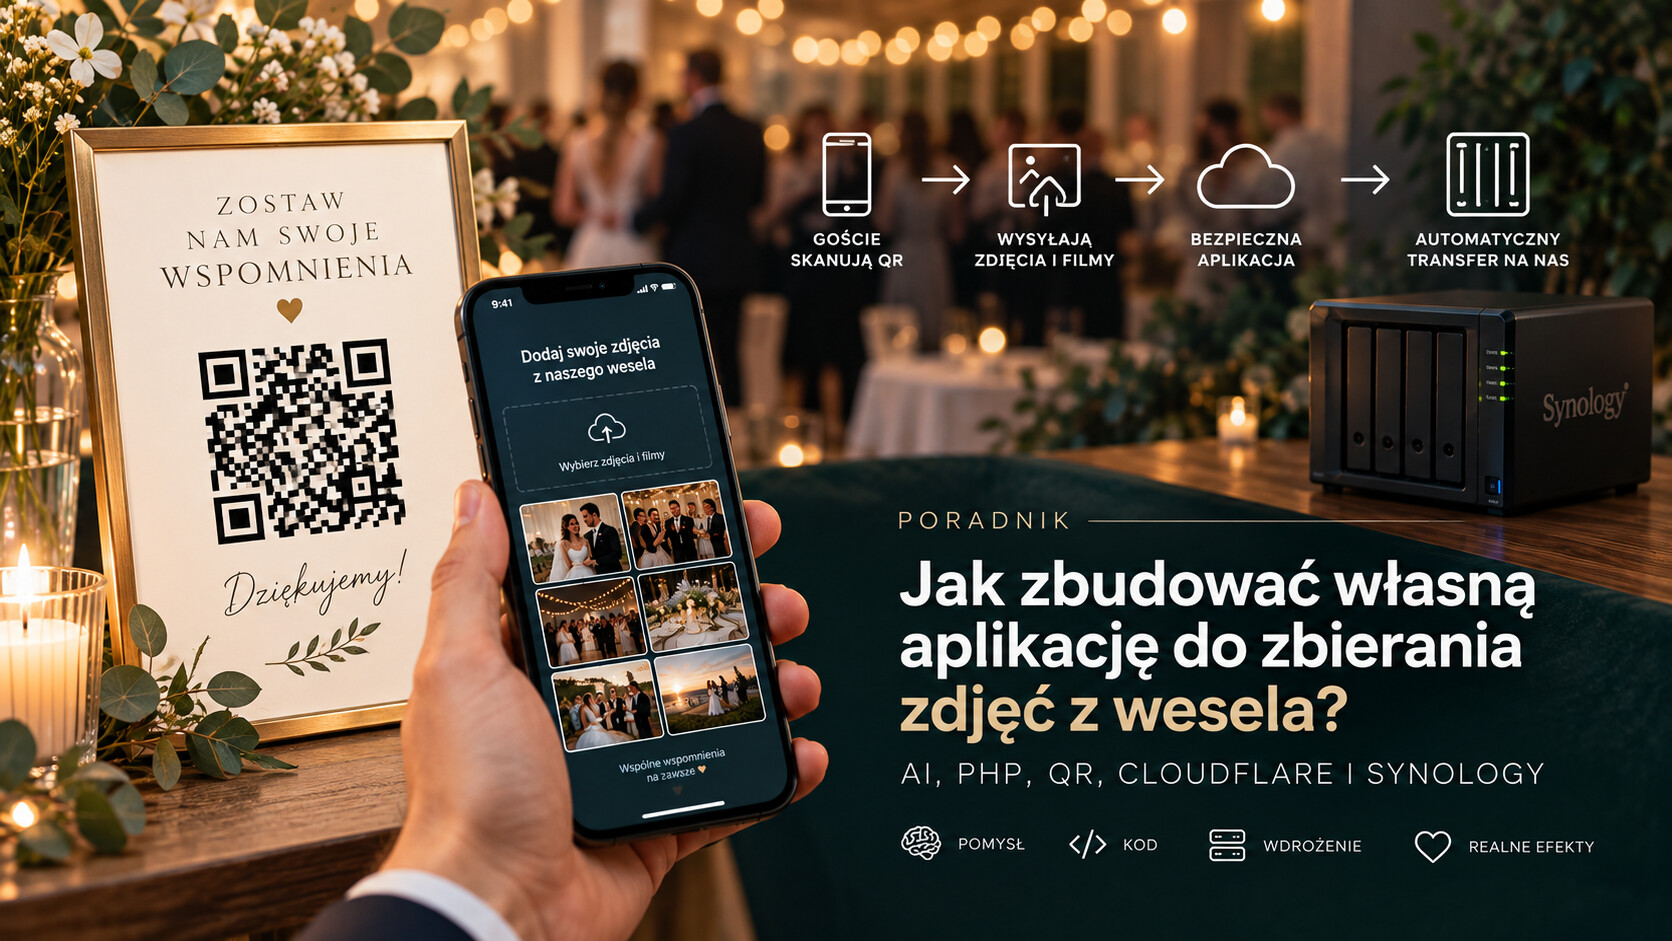
Założenie było proste:
gość skanuje QR, wpisuje kod, wybiera zdjęcia lub filmy, a pliki trafiają automatycznie na mój prywatny NAS.
Do tego chciałem mieć prywatną galerię, podgląd zdjęć i możliwość późniejszego rozbudowania systemu.
Najciekawsze jest jednak to, że sporą część projektu można było zaprojektować i napisać z pomocą AI.
Nie chodziło jednak o jeden prompt:
„Napisz mi aplikację do zdjęć z wesela”.
To nie zadziałałoby dobrze.
Najlepsze rezultaty dało rozbicie projektu na małe etapy.
Co właściwie chciałem zbudować?
Docelowo cały system wygląda tak:
Gość
 ↓
QR
 ↓
kod dostępu
 ↓
aplikacja WWW
 ↓
upload zdjęć / filmów
 ↓
kolejka na hostingu
 ↓
worker
 ↓
Synology
 ↓
prywatna galeria
A najważniejsze było dla mnie jedno:
Synology nie miało być wystawione do Internetu.
Żadnego publicznego SFTP.
Żadnego przekierowania portów na routerze.
Żadnego dostępu do NAS z poziomu przeglądarki.
NAS pozostaje w prywatnej sieci, a worker na Synology sam wychodzi po HTTPS do aplikacji.
Architektura
Wykorzystałem:
- PHP,
- MariaDB,
- dhosting,
- Cloudflare,
- Synology DS416+,
- Python do workera,
- QR jako sposób wejścia do aplikacji.
Schemat wygląda tak:
                 INTERNET
                    │
                    ▼
              ┌──────────┐
              │ Cloudflare│
              └─────┬────┘
                    │
                   HTTPS
                    │
                    ▼
              ┌──────────┐
              │ dhosting │
              │ PHP      │
              │ MariaDB  │
              └─────┬────┘
                    │
                kolejka
                    │
                    ▼
              ┌──────────┐
              │ Synology │
              │ DS416+   │
              └──────────┘
Przeglądarka nigdy nie rozmawia bezpośrednio z NAS-em.
To rozwiązuje bardzo dużo problemów związanych z bezpieczeństwem.
QR jako wejście
Gość dostaje kod QR.
Po zeskanowaniu telefon otwiera adres zawierający losowy token.
Przykładowo:
https://moja-domena.pl/?k=LOSOWY_TOKEN
Aplikacja sprawdza token i tworzy sesję gościa.
Można również użyć ręcznego kodu dostępu.
Ważne jest, żeby kodu nie przechowywać w bazie jako zwykłego tekstu.
Kod dostępu jest przechowywany jako Argon2id, a token QR jako bezpieczny hash/HMAC.
Ciekawostka: QR z logo
Przy tworzeniu grafiki QR łatwo wpaść w pułapkę generowania go przez AI.
AI potrafi stworzyć obraz, który wygląda jak kod QR.
Problem?
Może go nie dać się zeskanować.
Dlatego prawidłowy proces powinien wyglądać inaczej:
URL
 ↓
generator QR
 ↓
prawdziwy kod QR
 ↓
wysoka korekcja błędów
 ↓
logo na środku
 ↓
test dekodowania
 ↓
druk
Logo można umieścić w środku, ale nie powinno zajmować zbyt dużej powierzchni.
I koniecznie trzeba sprawdzić QR prawdziwym telefonem.
To jest dobry przykład sytuacji, w której AI może pomóc w projekcie graficznym, ale nie powinno odpowiadać za generowanie danych, które muszą być dokładne.
Upload dużych plików
Tutaj pojawił się pierwszy poważniejszy problem.
Zdjęcie może mieć kilka lub kilkanaście MB.
Film z iPhone’a może mieć natomiast setki MB.
Nie chciałem przesyłać wszystkiego jako jednego requestu HTTP.
Dlatego pliki są dzielone na fragmenty.
Przykładowo:
100 MB
 ↓
8 MB
8 MB
8 MB
8 MB
...
Każdy fragment jest zapisywany osobno.
Jeżeli jeden fragment się nie powiedzie, można wysłać go ponownie.
Możliwe jest też wznowienie uploadu.
Limit 10 GiB
Hosting ma ograniczoną ilość miejsca.
Dlatego aplikacja musi wiedzieć nie tylko, ile już zajmują pliki, ale również ile miejsca zostało zarezerwowane przez rozpoczęte uploady.
Zastosowałem:
AVAILABLE =
10 GiB
- USED
- RESERVED
To bardzo ważne przy równoległych uploadach.
Wyobraźmy sobie, że zostało 500 MB.
Dwie osoby jednocześnie próbują wysłać po 400 MB.
Bez rezerwacji obie mogą dostać odpowiedź:
OK, mamy jeszcze 500 MB
i razem spróbują zapisać 800 MB.
Dlatego miejsce jest rezerwowane przed zapisaniem pierwszego fragmentu.
Jeśli miejsca nie ma:
HTTP 507
i użytkownik dostaje normalny komunikat po polsku.
Kolejka plików
Każdy upload ma własny UUID i status.
Przykładowo:
UPLOADING
    ↓
READY
    ↓
TRANSFERRING
    ↓
COMPLETED
W przypadku problemu:
FAILED
Dzięki temu worker wie, które pliki ma pobrać.
Worker na Synology
Na Synology działa mały program w Pythonie.
Nie potrzebuje Dockera.
Nie działa też jako permanentny daemon.
Uruchamia go Task Scheduler DSM.
W moim przypadku worker sprawdza kolejkę co minutę.
Czyli:
Task Scheduler
      ↓
worker.py
      ↓
heartbeat
      ↓
sprawdzenie kolejki
      ↓
lease
      ↓
pobranie pliku
      ↓
SHA-256
      ↓
zapis na NAS
      ↓
ACK
To rozwiązanie ma jeszcze jedną zaletę.
Jeżeli NAS jest wyłączony, hosting nadal może przyjmować pliki.
Po prostu kolejka czeka.
Dlaczego HTTP Range?
Duży plik nie jest pobierany jednym requestem.
Worker wykorzystuje:
Range
Przykładowo:
bytes=0-16777215
bytes=16777216-33554431
bytes=33554432-50331647
Jeżeli transfer zostanie przerwany, worker może kontynuować od miejsca, w którym skończył.
W testach zrobiłem dokładnie taki scenariusz.
Transfer został przerwany po 32 MiB.
Po ponownym uruchomieniu workera:
start=33554432
Czyli worker nie zaczął pobierania od zera.
Po zakończeniu SHA-256 był zgodny.
SHA-256 jako kontrola integralności
Nie chciałem zakładać, że skoro plik się przesłał, to wszystko jest OK.
Dlatego po stronie hostingu wyliczany jest SHA-256.
Worker zapisuje plik na Synology i sprawdza jego hash.
Oczekujemy:
SHA-256 dhosting
       =
SHA-256 Synology
Dopiero wtedy wykonywany jest ACK.
Po ACK:
COMPLETED
a plik znika z kolejki.
Dzięki temu miejsce w buforze jest zwalniane dopiero po poprawnym transferze.
Prywatna galeria
Oryginałów nie trzymam na publicznym hostingu.
Po poprawnym transferze trafiają na:
Synology
/Wesele/originals/
Na hostingu zostają natomiast wersje przeznaczone do galerii:
thumbnail
preview
Przykładowo:
thumbnail → około 480 px
preview   → około 1600 px
Dzięki temu gość może oglądać zdjęcia, ale aplikacja nie potrzebuje dostępu do oryginałów na NAS.
Galeria ma:
- 2 kolumny na telefonie,
- więcej kolumn na większych ekranach,
- lazy loading,
- paginację,
- sortowanie,
- lightbox,
- fullscreen.
Pliki poza publicznym katalogiem
To jeden z ważniejszych elementów całego projektu.
Nie:
public/uploads/zdjecie.jpg
tylko:
storage/
├── queue/
├── chunks/
└── gallery/
    ├── thumbnails/
    ├── previews/
    └── videos/
storage znajduje się poza document rootem.
Dostęp do plików realizuje aplikacja.
Dzięki temu nie można po prostu wpisać:
https://domena.pl/storage/...
i dostać pliku.
Ochrona galerii
Endpointy mediów wymagają aktywnej sesji.
Przykładowo:
/media/thumb/{uuid}
/media/preview/{uuid}
/media/video/{uuid}
Bez sesji aplikacja zwraca:
404
zamiast informować użytkownika, czy konkretny plik istnieje.
Do tego dochodzą zabezpieczenia przed:
- IDOR,
- path traversal,
- SQL injection,
- XSS,
- CSRF.
Cloudflare też trzeba skonfigurować
Cloudflare jest tutaj przede wszystkim warstwą:
- DNS,
- HTTPS,
- ochrony,
- rate limitingu,
- filtrowania ruchu.
Nie chcemy natomiast cache’ować prywatnych odpowiedzi.
Dlatego ścieżki takie jak:
/media/*
/admin/*
/api/*
/upload/*
/gallery/*
są wyłączone z cache.
Aplikacja dodatkowo korzysta z:
Cache-Control: private, no-store
Vary: Cookie
Dzięki temu nie powinno dojść do sytuacji:
Gość A
 ↓
otrzymuje zdjęcie
 ↓
Cloudflare cache
 ↓
Gość B
 ↓
otrzymuje cudze zdjęcie
To jeden z testów, które warto wykonać podczas budowania takiej aplikacji.
Co z HEIC?
Zdjęcia z iPhone’a mogą być zapisane jako HEIC/HEIF.
Nie chciałem uzależniać całego uploadu od tego, czy serwer ma odpowiedni dekoder.
Dlatego:
HEIC
 ↓
upload OK
 ↓
oryginał → NAS
Jeżeli serwer potrafi odczytać HEIC, generowany jest podgląd.
Jeżeli nie:
placeholder
ale oryginał nadal zostaje zachowany.
To jest lepsze niż blokowanie całego uploadu.
A co z filmami?
Film jest jeszcze trudniejszy.
Nie ma sensu instalować FFmpeg tylko po to, żeby zrobić miniaturę.
Dlatego w podstawowym wariancie film może być pokazany jako:
┌───────────────┐
│               │
│       ▶       │
│     FILM      │
│               │
└───────────────┘
Oryginał trafia na NAS.
Można później dodać możliwość pozostawiania kopii filmów na hostingu, ale trzeba wtedy pamiętać, że taki plik zużywa miejsce poza limitem kolejki.
Jak AI pomagało w projekcie?
Największą różnicę zrobiło nie pytanie:
„Zbuduj mi aplikację”.
Tylko prowadzenie AI etapami.
Najpierw architektura.
Potem baza.
Potem bezpieczeństwo.
Następnie upload.
Później worker.
Na końcu galeria.
Dzięki temu można było po każdym etapie zrobić testy i poprawić błędy, zanim pojawiły się kolejne warstwy.
Przykładowe prompty do AI
Poniżej kilka promptów, które można wykorzystać przy podobnym projekcie.
1. Najpierw architektura
Chcę zbudować prywatną aplikację WWW do zbierania zdjęć i filmów od użytkowników.

Stack:
- PHP
- MariaDB
- hosting współdzielony
- Cloudflare
- prywatny Synology NAS bez publicznego IP

Użytkownik ma:
1. wejść przez QR lub kod,
2. przesłać wiele zdjęć i filmów,
3. zobaczyć prywatną galerię.

Oryginały mają trafiać na NAS.

NAS nie może być dostępny bezpośrednio z Internetu.

Zaprojektuj architekturę systemu, uwzględniając:
- upload chunkowany,
- kolejkę,
- limit miejsca,
- retry,
- SHA-256,
- transfer przez HTTPS,
- bezpieczeństwo sesji,
- prywatną galerię.

Najpierw przygotuj dokument architektury. Nie pisz jeszcze kodu.
2. Prompt dotyczący uploadu
Zaprojektuj mechanizm chunkowanego uploadu w PHP.

Wymagania:
- duże pliki,
- wiele równoległych uploadów,
- możliwość wznowienia,
- retry pojedynczego chunka,
- SHA-256 po złożeniu,
- limit całkowitego bufora 10 GiB.

Musi istnieć USED i RESERVED.

Miejsce należy rezerwować przed rozpoczęciem uploadu.

Nigdy nie może dojść do:
USED + RESERVED > 10 GiB.

Zaprojektuj bazę danych, endpointy API i mechanizm transakcyjny.

Najpierw opisz rozwiązanie. Nie pisz kodu.
3. Prompt dotyczący bezpieczeństwa
Przeprowadź security review prywatnej aplikacji PHP.

Aplikacja ma:
- sesje gości,
- sesje administratorów,
- upload plików,
- prywatną galerię,
- endpointy /media/{uuid},
- MariaDB,
- Cloudflare.

Sprawdź szczególnie:
- IDOR,
- path traversal,
- CSRF,
- XSS,
- SQL injection,
- enumerację UUID,
- cache leakage,
- dostęp bez sesji,
- możliwość pobrania plików z storage,
- możliwość obejścia limitu uploadu.

Nie zmieniaj kodu. Najpierw wypisz wszystkie problemy według poziomu ryzyka.
4. Prompt dla workera
Zaprojektuj workera w Pythonie działającego na Synology.

NAS nie ma publicznego dostępu z Internetu.

Worker ma wychodząco łączyć się po HTTPS z aplikacją PHP.

Ma:
- pobierać kolejkę,
- otrzymywać lease,
- pobierać pliki przez HTTP Range,
- obsługiwać resume,
- zapisywać .part i .progress,
- sprawdzać SHA-256,
- zapisywać plik na NAS,
- wysyłać ACK,
- obsługiwać retry.

Autoryzacja:
Bearer token + HMAC-SHA256 + nonce + timestamp.

Nie używaj Dockera ani stałego daemona.

Najpierw przygotuj protokół komunikacji między workerem a aplikacją.
5. Prompt do testów
Mam gotową aplikację PHP do prywatnego uploadu zdjęć i filmów.

Przygotuj kompletny plan testów.

Uwzględnij:
- poprawny upload,
- równoległe uploady,
- brak miejsca,
- przerwanie uploadu,
- wznowienie,
- uszkodzony plik,
- błędny MIME,
- HEIC,
- IDOR,
- path traversal,
- CSRF,
- XSS,
- SQL injection,
- wygasłą sesję,
- wygasły lease,
- przerwany transfer na NAS,
- SHA-256 mismatch,
- cache leakage.

Dla każdego testu podaj:
- scenariusz,
- oczekiwany wynik,
- status HTTP,
- co należy sprawdzić w bazie,
- co należy sprawdzić na filesystemie.
Najważniejsza rzecz, której nauczył mnie ten projekt
AI bardzo dobrze radzi sobie z budowaniem takich systemów, ale nie powinno dostawać całego problemu naraz.
Najlepszy efekt daje:
pomysł
 ↓
architektura
 ↓
dokumentacja
 ↓
baza
 ↓
jeden moduł
 ↓
testy
 ↓
kolejny moduł
 ↓
testy
 ↓
integracja
 ↓
test E2E
I przede wszystkim: AI nie powinno samo decydować o rzeczach, których skutki mogą być trudne do odwrócenia.
Przy tym projekcie dotyczyło to szczególnie:
- dostępu do NAS,
- konfiguracji Cloudflare,
- bazy produkcyjnej,
- sekretów,
- limitów miejsca,
- usuwania oryginalnych plików.
W takich miejscach lepiej, żeby AI przygotowało rozwiązanie i powiedziało „teraz potrzebuję Twojej decyzji”, zamiast bez pytania wykonywać zmianę.
Podsumowanie
Z pozoru powstała prosta aplikacja:
„zeskanuj QR i wrzuć zdjęcia z wesela”.
W środku jest jednak:
QR
+
sesje
+
PHP
+
MariaDB
+
chunked upload
+
rezerwacja miejsca
+
kolejka
+
SHA-256
+
HMAC
+
worker Python
+
HTTP Range
+
Synology
+
prywatna galeria
+
Cloudflare
I właśnie dlatego taki projekt jest dobrym przykładem AI w praktyce.
Nie chodzi o to, żeby AI napisało cały projekt jednym promptem.
Chodzi o to, żeby wykorzystać AI jako partnera do projektowania, programowania, testowania i code review, a człowiek cały czas kontrolował architekturę i decyzje dotyczące bezpieczeństwa.